[BizHanKook] 人工知能(AI)競争の重心が、大規模言語モデル(LLM)の学習とグラフィックス処理装置(GPU)の確保から、実際のサービスを運営する推論とコスト効率へと移っている。半導体の性能だけでなく、ソフトウェアやネットワーク、ストレージに至るまでを最適化しなければならない状況下で、AMDが韓国のAI企業各社と共に、異なる演算半導体を組み合わせたインフラの実証に乗り出す。韓国企業の半導体とソフトウェアをAMDのエコシステムに組み込み、国内で検証したシステムをグローバル市場へと拡大する構想だ。
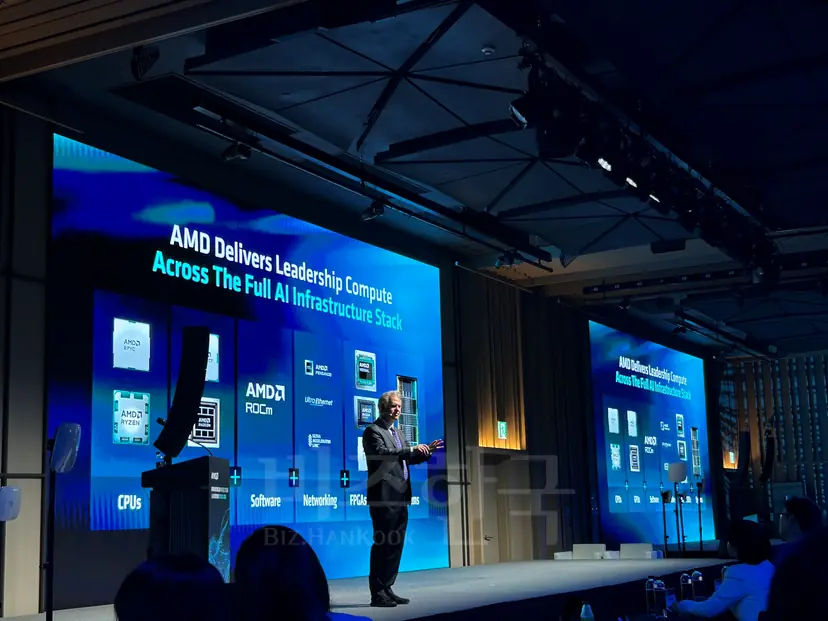
AMDは4日、ソウル市江南区のウェスティン朝鮮ソウルにて「アドバンシングAIワールドツアー・ソウル2026」を開催し、グローバルAI戦略と韓国国内での協力の方向性を共有した。米国中心に開催してきた年次技術イベントを韓国国内で行うのは今回が初めてとなる。FuriosaAI(フリオサAI)、MangoBoost(マンゴブースト)、Moreh(モレ)などの国内AI半導体・インフラ企業や、ネイバークラウドといったパートナー企業も参加し、技術や適用事例を紹介した。
国産NPUを加えた異種インフラ、韓国を「実証拠点」に
AMDのグローバルAIマーケット統括シニアバイスプレジデント、キース・ストライヤー氏は基調講演で、FuriosaAI、MangoBoostと共に2027年春、ソウルに初のレファレンスクラスターを構築すると発表した。AMDの中央演算処理装置(CPU)とGPUに、国内AI半導体企業FuriosaAIのニューラルネットワーク処理装置(NPU)、データセンターインフラ半導体・システム企業MangoBoostのデータ処理装置(DPU)を組み合わせる方式だ。3社はこの日、業務提携(MOU)も締結した。CPUは作業の調整を、GPUは大規模演算を、NPUはAI推論を、DPUはネットワーク・データ移動を担うことで、それぞれの半導体の長所を活かす。
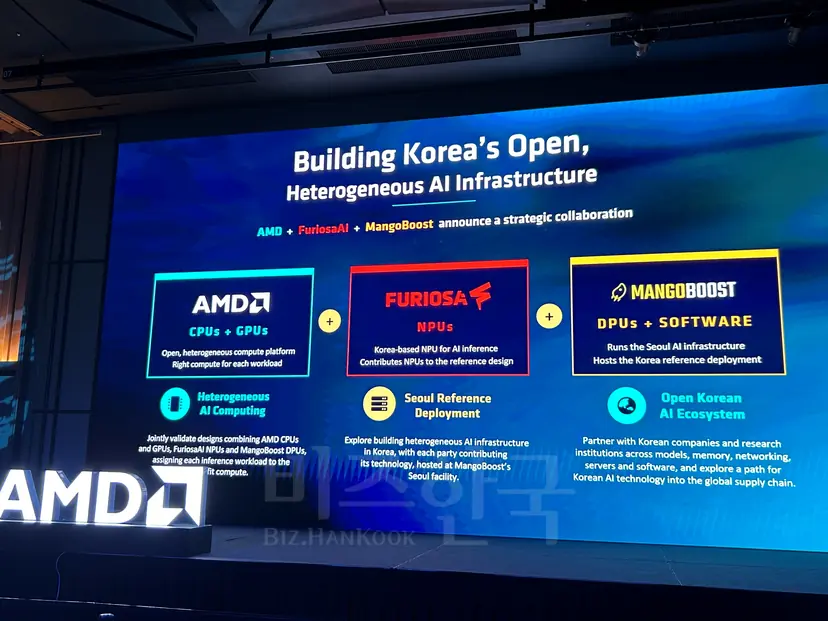
レファレンスクラスターとは、複数の半導体とソフトウェアが実際のデータセンター環境で正常に作動するかを検証し、他社が導入する際の参考基準となるシステムのことである。ストライヤー氏は「7月のMOU締結時、AMDの技術を韓国に持ち込むだけでなく、韓国の技術をAMDのエコシステムに統合すると約束した」とし、「異種AIインフラがどのような姿になるかを示すと同時に、韓国のパートナーとの約束を果たす最初の事例となるだろう」と語った。
ストライヤー氏は「あらゆるワークロードを満たす単一のチップは存在せず、単一の構成やラックだけで全てのニーズを解決することもできない」と強調した。GPU72基を組み合わせたラック単位のシステム「ヘリオス」は、2027年までに世界中の主要データセンターやクラウドに導入される予定だ。AIエージェントの普及に伴い、作業調整を担うCPUの役割も再び重要視されている。ストライヤー氏は「来年1年間で販売するCPUの数は、ここ数年間の販売量の合計を上回るだろう」と予測した。
科学技術情報通信部とAMDの協力も具体化している。先立って7月、AIコンピューティングインフラの構築やAMD AI研究センターの設立、人材育成などを盛り込んだMOUを締結していた。AMDは10月、数百人規模の研究人員を擁する国内AI研究センターの設立計画も発表した。科学技術情報通信部のイ・ドギュ情報通信政策室長はこの日のパネルディスカッションで、「(MOUには)韓国の国産NPUと協力するという内容が含まれている」とし、「非常に異例なことだ」と語った。
MOUは通常包括的に結ばれるものだが、AMDのCPU・GPUと韓国のNPUの協力をピンポイントで指定しており、これに基づいて現場で協力が進んでいるという説明だ。政府は来年、国産NPUをベースにAMDのCPU・GPUなど多様な組み合わせを統合した大規模な実証レファレンスを構築し、公共・民間および海外の需要先による導入を支援する計画だ。
コスト競争力の立証が「課題」
韓国企業の役割は、半導体の供給にとどまらない。AMDのAI製品管理部門バイスプレジデント、ラミン・ロアン氏は「韓国のエコシステムパートナーと共に、ROCmをベースにした韓国型ソフトウェアスタックを構築している」と明らかにした。AIモデルをサービス化するには、ハードウェアに合わせて演算を最適化し、新しいモデルが登場するたびにソフトウェアのアップデートを繰り返さなければならない。また、複数の機器が一つのシステムのように運営される必要がある。
AIインフラソフトウェア企業のMorehは、データセンターがGPU演算リソースを貸し出す段階から進み、モデルを直接運営してトークンを提供する「トークンファクトリー」へと変化していると分析した。Morehのチョ・ガンウォン代表は、AMDのROCm上にチップ・クラスター単位の最適化ソフトウェアを組み合わせることで、最新モデルを迅速にサポートし、AMDやNVIDIAなどの異なるGPUはもちろん、将来的には国産NPUまでも一緒に使える構造を開発中だと説明した。Morehは自社の測定結果として、GLMモデルの推論処理能力が、一般的なNVIDIAのGPUと標準的なオープンソースソフトウェアの組み合わせよりも約2倍高いと明らかにした。自社データセンターを構築する企業は、外部のトークンサービスを利用するよりも運営費を約半分に削減できるというのが同社の説明だ。
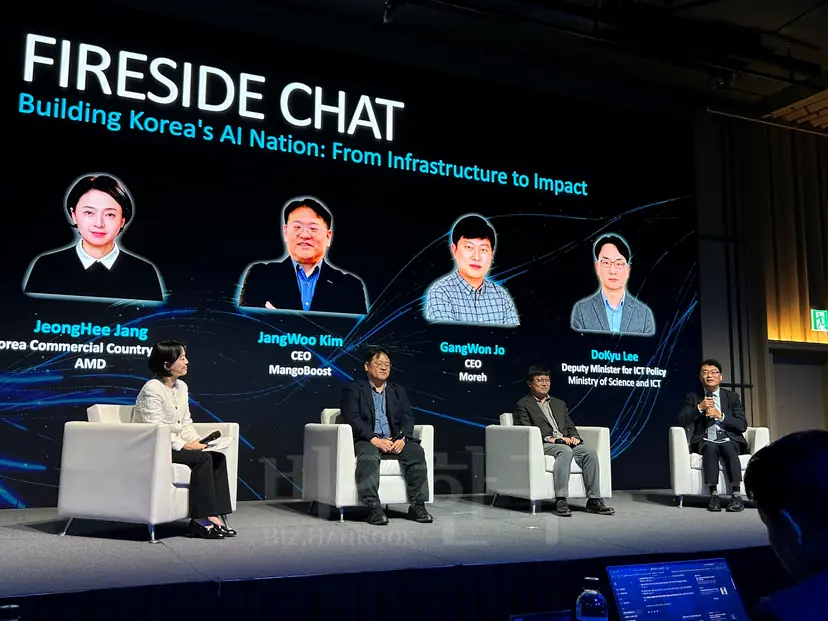
MangoBoostは、ネットワークとストレージ、アクセラレーター、ソフトウェアを統合的に最適化するシステム能力の重要性を強調した。MangoBoostのキム・ジャンウ代表は「データの主権も重要だが、それ以上に重要なのは『AIが非常に高価である』という点だ」とし、韓国の大企業のGPU効率を高め、独自のハードウェアを組み合わせることでコスト対性能を2倍以上改善した事例を紹介した。
ネイバークラウドのクラウドテクノロジーグループセンター長、パク・ヨンヒ氏は、AMDのサーバー用CPU「EPYC(エピック)」を搭載した運営サーバー約3万5000台を運用していると明かした。インテルベースのシステムよりラック空間を20〜25%削減し、電力や冷却を含む総所有コスト(TCO)を考慮して導入を拡大したという説明だ。
ただし、異種インフラが市場に定着するためには、異なる半導体が安定的に互換し、性能とコストを客観的に立証しなければならない。チョ代表は「特定のベンダーが『1年間韓国にGPUを供給しない』と決断すれば、現在はデータセンターを建設できない環境だ」と指摘した。他の半導体を導入するだけでなく、供給元が変わってもデータセンターを運営できるソフトウェアとシステム能力が必要だという意味だ。
イ室長は「政府は、我が国企業がグローバルオープンエコシステムの中で適正なパートナーとしての役割を果たせるよう最大限支援する予定であり、重要な機密情報は国内で処理できるよう環境構築に努めている」と述べた。